Nous avons annoncé notre partenariat avec Dell mardi. Depuis, on m'a posé trois fois la même question : « Concrètement, ça donne quoi, une IA qui tourne chez le client ? »
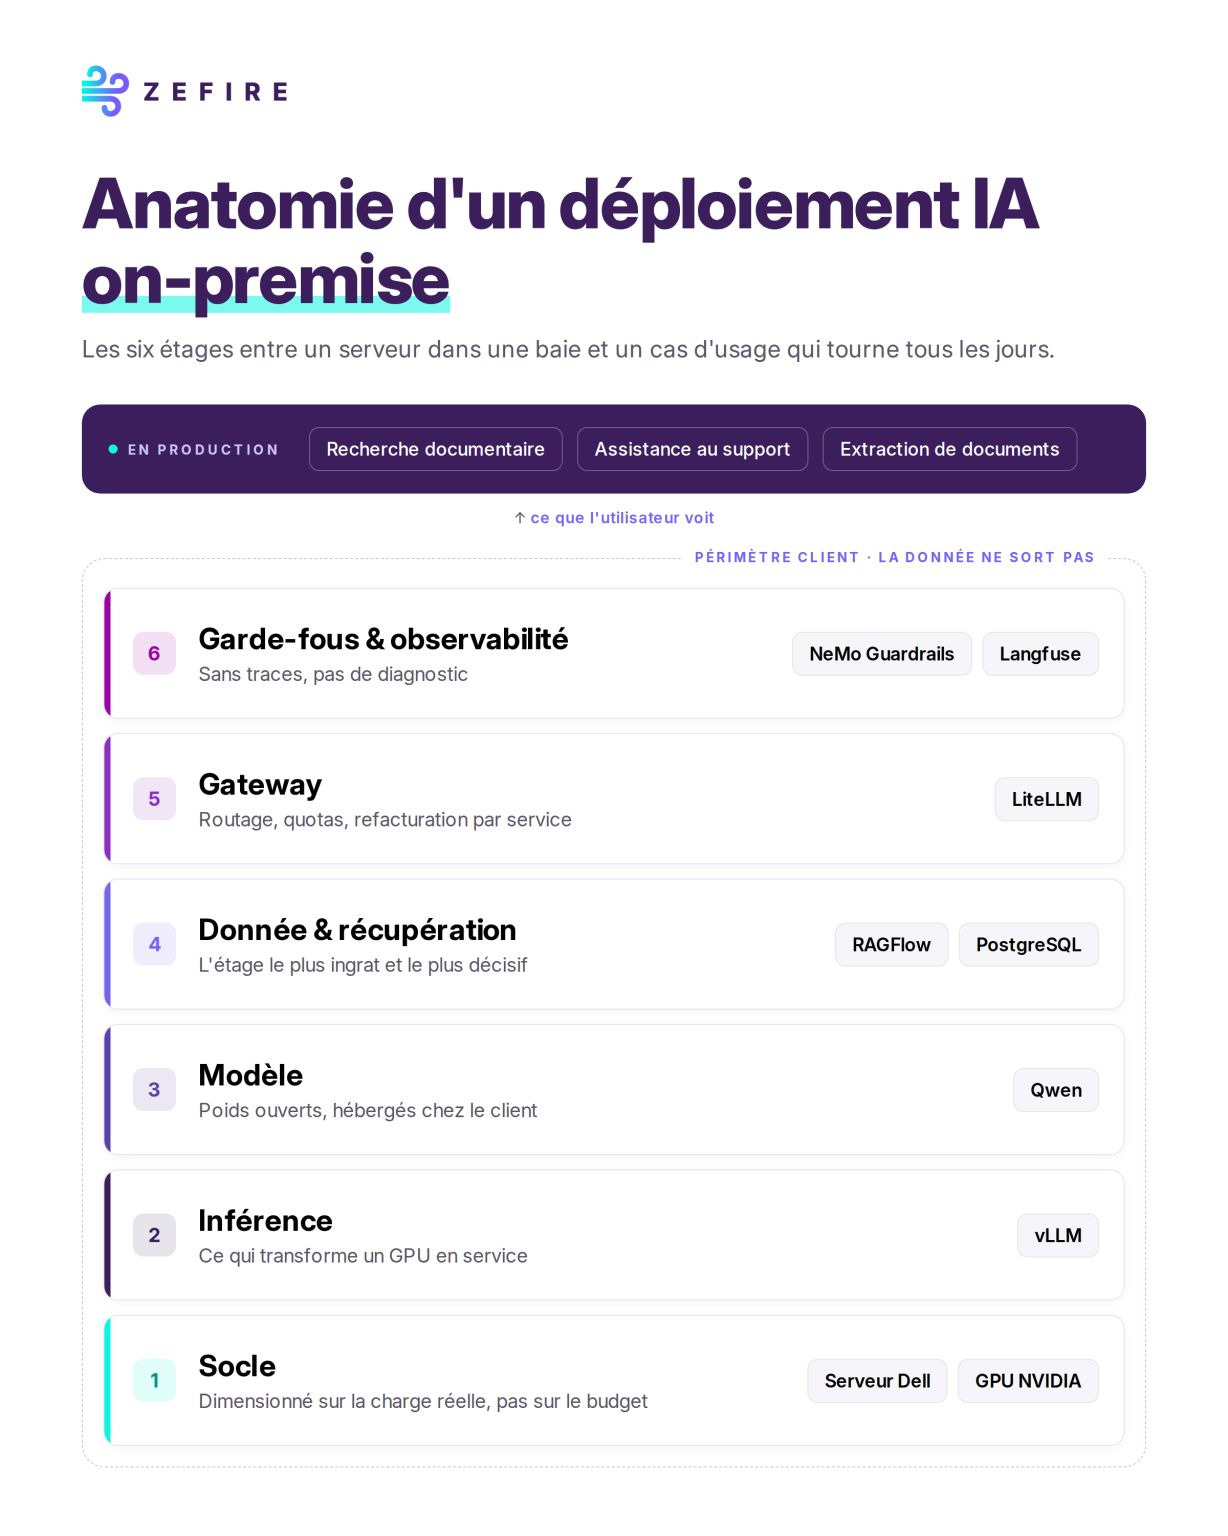
La question est bonne. « IA souveraine » ou « IA on-prem », on l'entend souvent, mais on voit rarement ce qu'il y a dedans. Voici donc l'anatomie complète, couche par couche, du matériel jusqu'au cas d'usage.
1. Le socle : serveur et GPU
Tout commence par du matériel : un serveur Dell, des GPU NVIDIA.
Le seul vrai piège à ce niveau, c'est le dimensionnement. Il faut partir de la charge réelle, pas du budget disponible. Trois questions comptent :
- Combien d'utilisateurs simultanés ?
- Quelle longueur de contexte ? (documents longs, historiques de conversation)
- Quel temps de réponse est acceptable ?
Un GPU sous-dimensionné ne donne pas un projet lent. Il donne un projet abandonné. Les utilisateurs ne reviennent pas vers un outil qui les fait attendre.
2. Le moteur d'inférence : vLLM
Une carte graphique ne suffit pas. Il faut une couche qui en fasse un service, et c'est le rôle du moteur d'inférence. Nous utilisons vLLM, qui gère le batching des requêtes, la mémoire et le débit.
C'est à cet étage qu'on passe d'une démo pour un utilisateur à un service utilisé par deux cents personnes en même temps. Beaucoup de projets qui « marchaient bien en POC » échouent ici.
3. Le modèle : Qwen par défaut
Chez nous, le modèle par défaut est Qwen. Ses poids sont ouverts, il est hébergé sur les serveurs du client et il ne fait aucun appel sortant. Les données ne quittent pas l'infrastructure.
Nous choisissons le modèle en fonction de la tâche, pas du classement du mois. Les benchmarks changent toutes les semaines, alors qu'un cas d'usage en production doit rester stable.
Retenez une règle : un modèle moyen bien servi bat un excellent modèle mal servi.
4. La donnée : RAGFlow et PostgreSQL
C'est l'étage le plus ingrat, et c'est aussi le plus décisif.
- RAGFlow gère l'ingestion et la recherche documentaire.
- PostgreSQL stocke les données structurées et applicatives, avec une couche sémantique par-dessus.
La qualité d'un assistant documentaire ne dépend pas du choix du LLM. Elle se joue sur deux points moins visibles : le découpage des documents et la gestion des droits d'accès. Un mauvais découpage donne des réponses à côté. Des droits mal gérés donnent un assistant qu'on ne peut pas ouvrir à toute l'entreprise.
5. La porte d'entrée : une gateway (LiteLLM)
Toutes les requêtes passent par une gateway. Nous utilisons LiteLLM, qui assure :
- le routage entre les modèles ;
- les quotas ;
- la traçabilité ;
- la refacturation par service.
Sans gateway, personne ne sait qui consomme quoi. Au bout de six mois, on ne peut plus piloter le projet : impossible de justifier les coûts, d'arbitrer entre les équipes ou de prévoir l'extension.
6. Les garde-fous et l'observabilité : NeMo Guardrails et Langfuse
Deux briques ferment l'architecture :
- NeMo Guardrails pour filtrer les entrées et les sorties ;
- Langfuse pour l'observabilité : traces, latences, qualité des réponses.
Le raisonnement est simple. Sans traces, on ne peut pas diagnostiquer. Sans diagnostic, on ne peut pas améliorer.
Au bout de la chaîne : un cas d'usage
Toutes ces couches ne servent qu'à faire tourner un cas d'usage, par exemple :
- la recherche documentaire sur un fonds technique ;
- l'assistance aux équipes support ;
- l'extraction de données à partir des documents entrants.
Rien de spectaculaire, mais ce sont des outils qui tournent tous les jours et que les équipes utilisent vraiment.
Ce que le schéma ne montre pas
Une architecture tient en un schéma. Ce qui prend le plus de temps, c'est ce qu'on n'y voit pas :
- la reprise de l'existant documentaire : formats hétérogènes, doublons, versions obsolètes ;
- l'intégration au système d'information : annuaire, droits, applications métier ;
- l'exploitation une fois en production : mises à jour, supervision, évolution des usages.
C'est précisément le travail que nous faisons avec les intégrateurs qui déploient ces architectures chez les PME et les ETI.
Vous êtes intégrateur et vous voulez proposer une IA déployée sur site à vos clients ? Parlons-en.